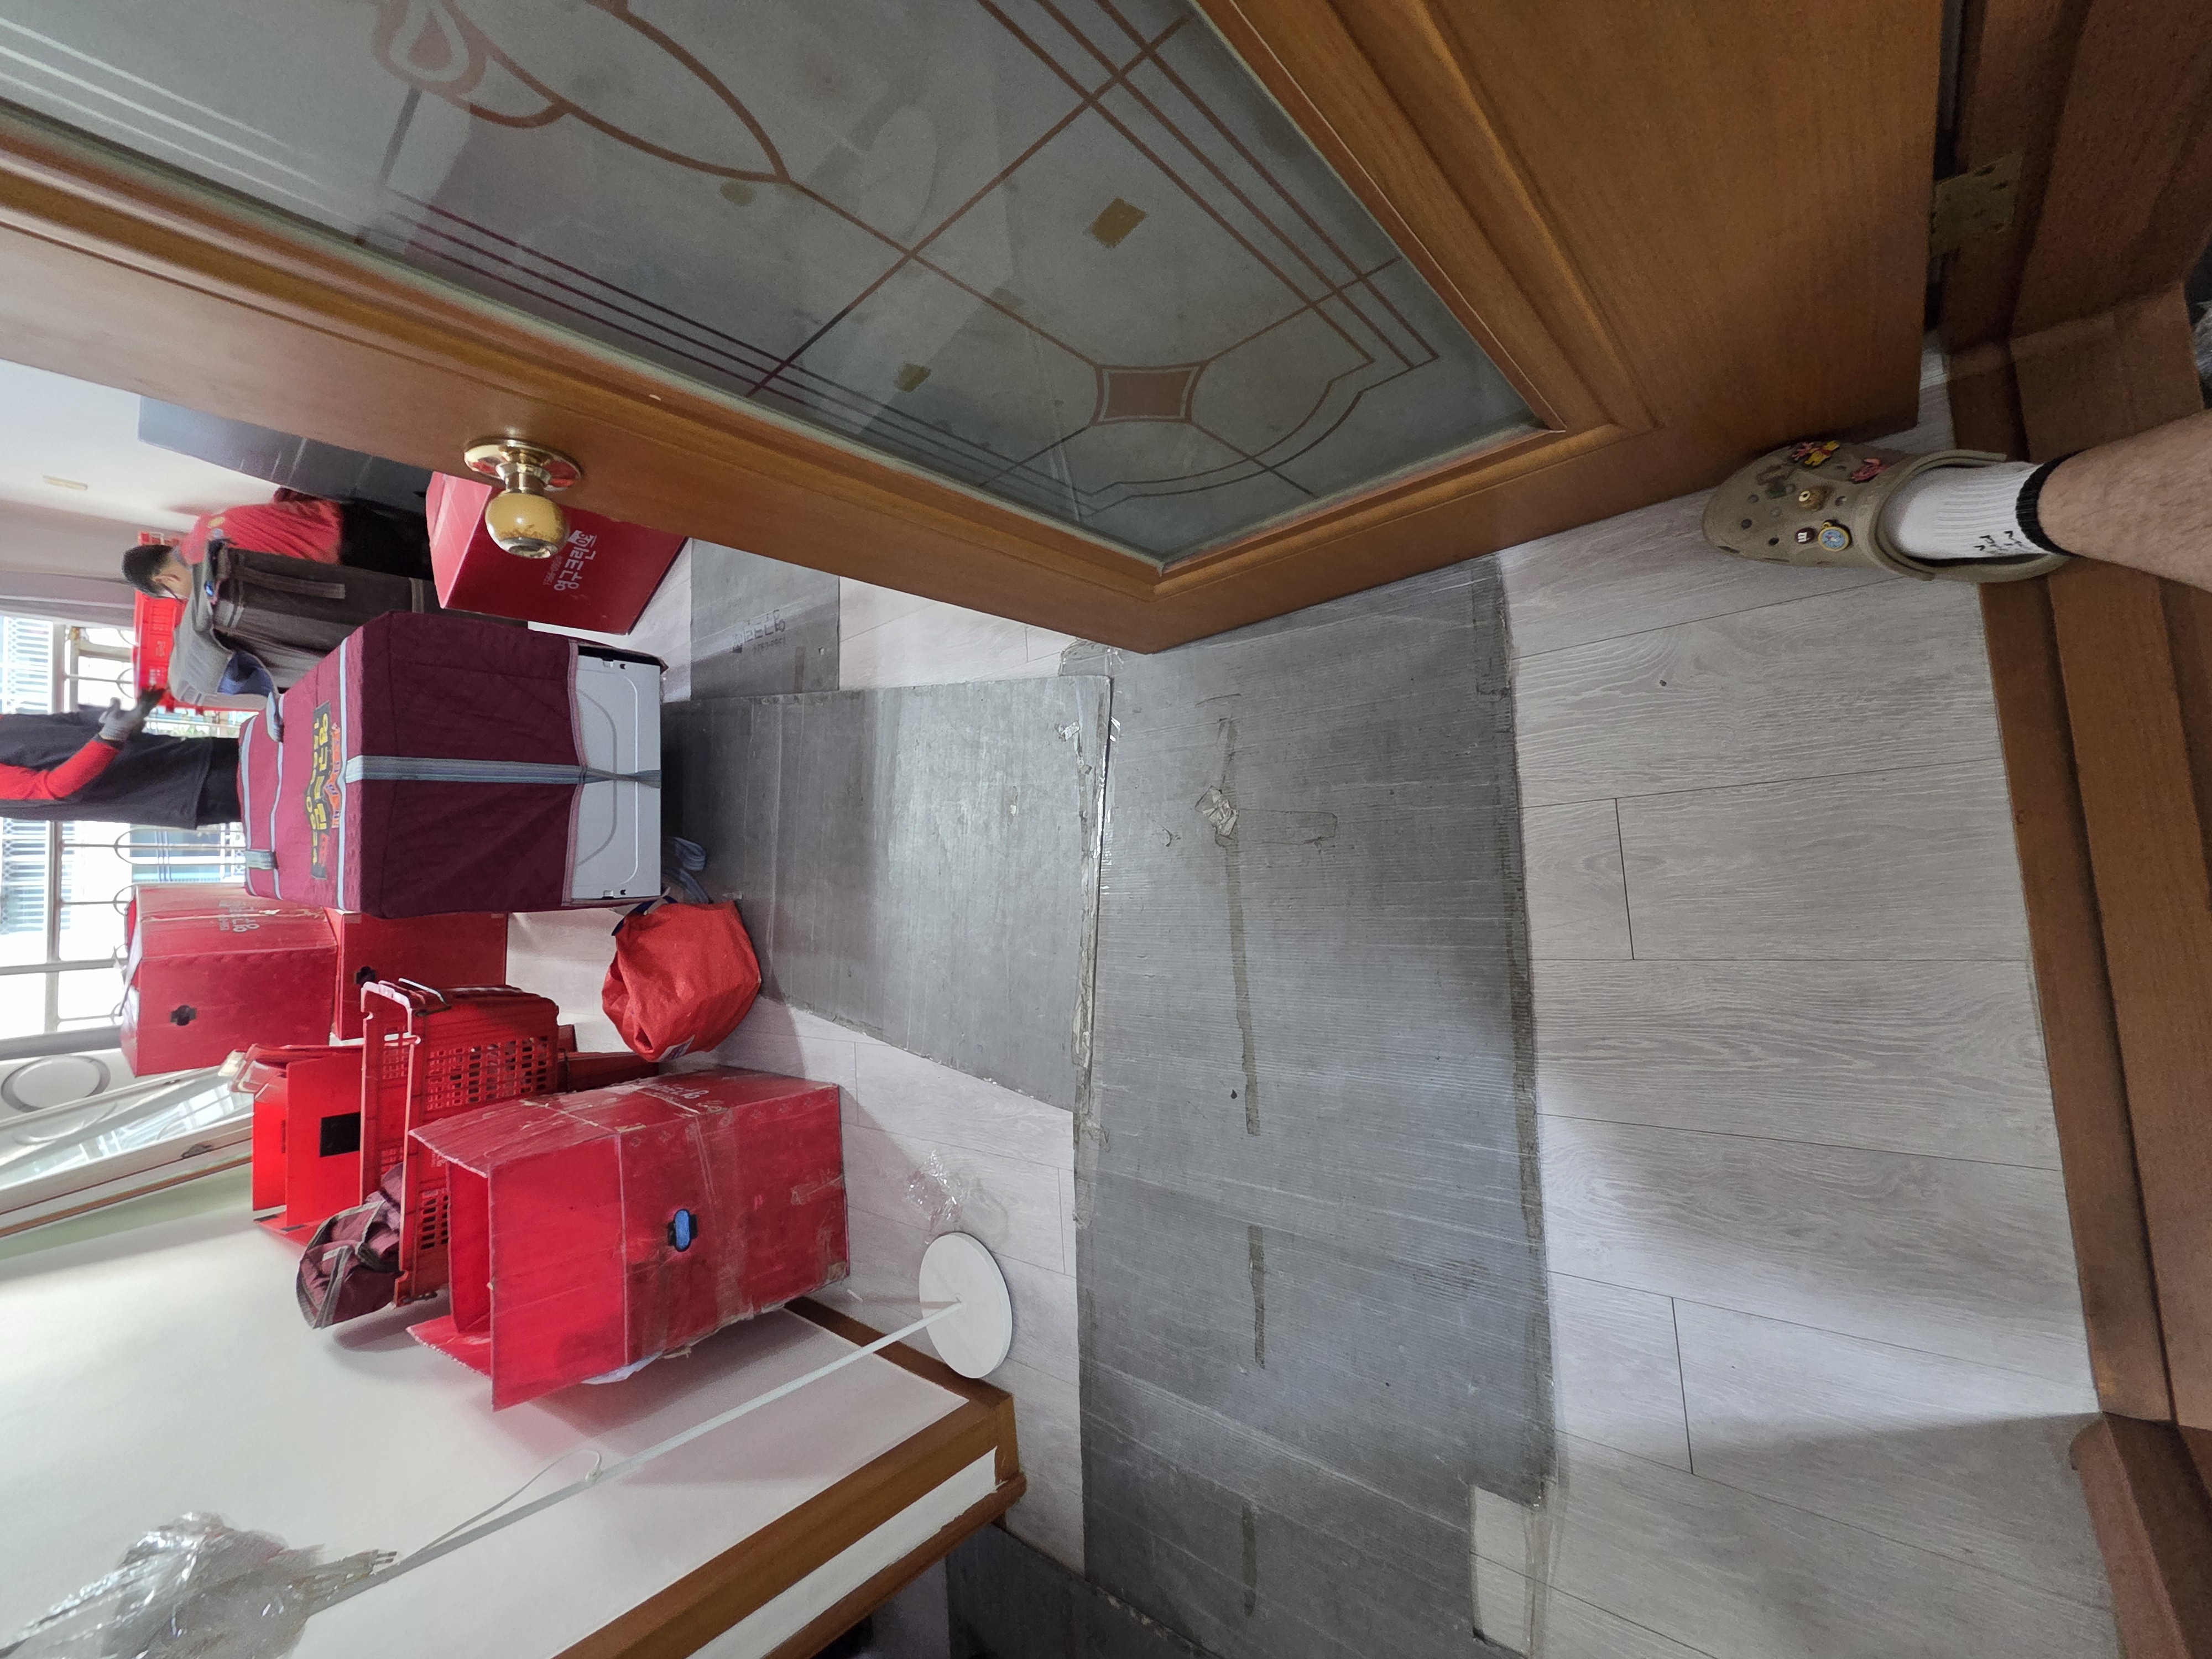
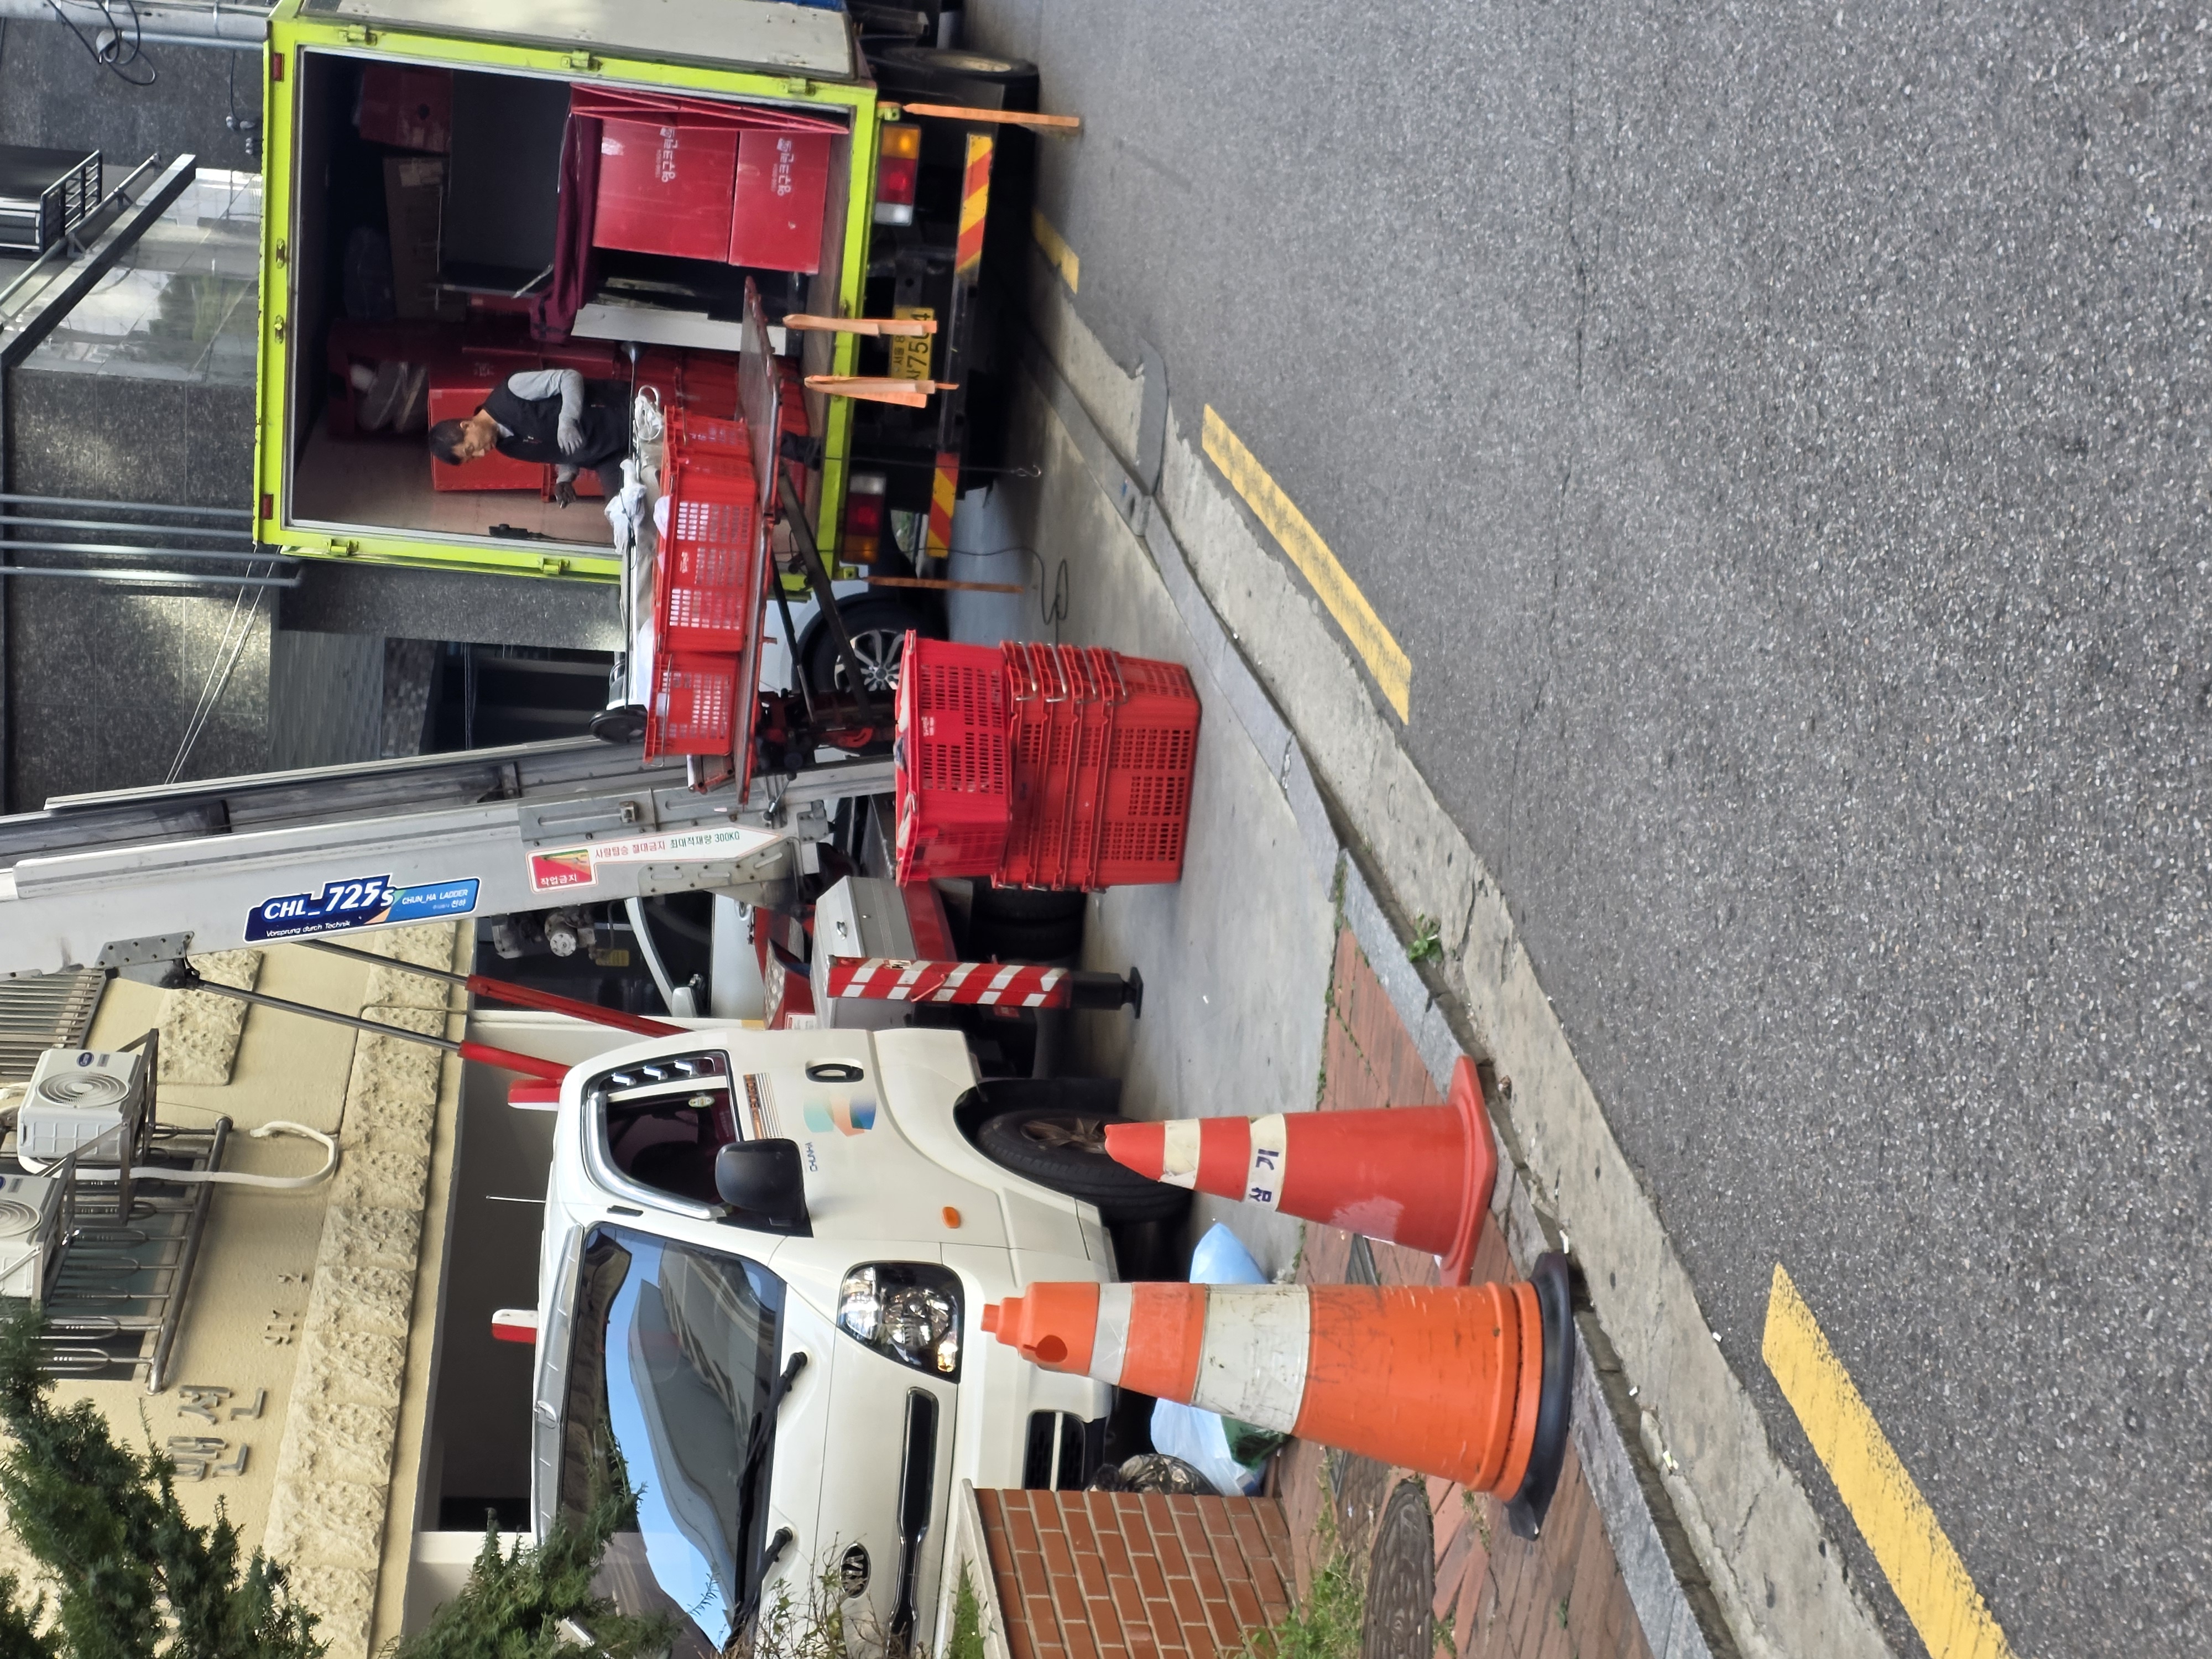
2인 신혼가구 포장이사로 여러 업체를 비교해 봤는데 다른 업체보다 가격이 저렴했고, 특히 주말과 공휴일 요금 차이가 커서 합리적으로 이용할 수 있었습니다. 포장도 꼼꼼하게 해주시면서 작업은 신속하고 정확하게 진행해 주셔서 믿음이 갔습니다. 무엇보다 팀원분들끼리 분위기가 좋고 서로 호흡이 잘 맞아 시너지가 느껴졌으며, 덕분에 이사 과정도 순조로웠습니다. 이모님께서도 세심하게 신경 써주시고 피드백이 정말 좋아서 더욱 만족스러웠습니다. 파손 면책 관련 안내와 처리도 확실해 안심할 수 있었고, 직렬 키트 설치까지 완벽하게 마무리해 주셨습니다. 가격부터 서비스, 마무리까지 어느 하나 아쉬운 점 없이 만족스러운 이사였습니다.
분리된 하나의 파일을 모듈(module)이라고 부르는데, 모듈은 대게 클래스 하나 혹은 특정한 목적을 가진 여러개의 함수를 포함하는 라이브러리로 구성되어 있음.
장점
유지보수 용이 : 기능들이 모듈화가 잘 되어 있는 경우, 의존성을 줄일 수 있기 때문에 기능개선이나 수정에 용이
네임스페이스화 : 코드양이 많을수로 전역스코프에 중복되는 변수병이 존재할수 있음, 이때 모듈로 분리하면 네임스페이스를 갖기 때문에 문제를 해결할수 있음
재사용성 : 같은 코드를 반복하지않고 중복되는 코드를 모듈로 분리시켜 필요할때 마다 재사용할 수 있다.
모듈 시스템 종류
AMD - 가장 오래된 모듈 시스템중 하나로 require.js라는 라이브러리를 통해 개발됨.
CommonJS - NodeJS 환경을 위해 만들어진 모듈 시스템
UMD - AMD와 CommonJS와 같은 다양한 모듈 시스템을 함께 사용하기 위해 만들어짐
ES Module - ES6(ES2015)에 도입된 자바스크립트 모듈 시스템
ES Module방식
> ES6에 도입된 자바스크립트 모듈로 <script> 태그에 type="module" 속성을 추가해주면, 해당 파일은 모듈로서 동작.
모듈을 외부에서 사용할수 있도록 내보낼때는 export, export default 와 같은 키워드를 사용하며, 외부에서 모듈을 불러 올때는 import 를 사용하여 모듈을 불러온다.
named export 를 사용하여 함수 또는 변수를 내보낼수 있음.
export default 를 사용하여 하나 기본함수를 내볼수 있음. (단, 모듈 당 하나만 내보낼수있음)
CommonJS방식
> NodeJS 환경에서 자바스크립트 모듈을 사용하기 위해 만들어진 모듈 시스템. 모듈을 외부에서 사용할 수 있도록 내볼때는 export, module.export 와 같은 키워드를 사용하며, 외부에서 불러올때는 require를 사용하여 모듈을 불러옴,
module.export 를 사용하여 하나의 객체로 묶어서 외부로 내보낼 수 있음.
ES Module for NodeJS
CommonJs 모듈 시스템을 채택했던 NodeJS환경에서 ES Module을 사용하려면 babel과 같은 트랜스파일러(transpiler)를 사용했어야 하는데, NodeJS 13.2 버전부터 ES모듈 시스템에 대한 정식 지원이 시작됨으로서 별다른 도구 필요 없이 NodeJS에서 ES Module을 사용할수 있게 되었다고 함.
Spring 개발을 하다보면 mapper.xml 에 간혹 ' WHERE 1=1 ' 을 보게 된다.
where 1=1 은 어떤이유 때문에 소스에 사용 되는지와 사용하지않는다면 어떤 대안이 있는지 알아볼까 한다..
( 필자는 where 1=1 을 사용시 DB실행에 불필요한 수식연산이 들어가여 자원을 잡아먹어 선호하지 않는 의견을 몇번 들어보긴 하였다.. )
WHERE 1=1 참(ture)을 의미
쿼리의 조건을 동적으로 사용하기위해 사용한다고 한다.
하지만, DLETE(삭제), UPDATE(수정) 기능을 수행하는 쿼리에서는 null판별이 옳바르게 전처리 작업이 수행되지 않는 상황에서 삭제나 수정 기능에 사용한다면 원치않는 결과를 초래할수 있다고한다. 왜냐하면 1=1 은 참이기때문에 모든 데이터를 삭제하거나, 모든데이터를 수정하는 일이 발생할수 있기때문이다.
정리하자면, 대부분에 동적인 상황을 고려하여 WHERE 1=1을 사용하는 경우가 대부분의 사용하는 이유가 될것이라고 필자는 생각한다, 하지만 의도치않는 예외적인 상황이 발생한다는 점을 고려한다면 좋은 방법은 아닌것이라고 생각이된다.
WHERE 1=1 에대해서 사용하는 이유와 반대로 WHERE 1=1 을 사용하지 말아야 한다는 이유를 찾다가 잘 정리된 2개의 블로그 게시글이 있어 공유한다. (판단은 본인이...)
전체쿼리 결과 집합을 쉼 없이 연속적으로 전송하지 않고 사용자로 부터 Fetch Call이 있을때 마다 일정량씩 나누어 전송하는 것을 '부분범위 처리'라고 한다.
정렬조건이 있을때 부분범위 처리
인덱스는 항상 정렬된 상태를 유지하므로 전체 데이터를 정렬하지 않고도 정렬된 상태의 결과집합을 바로 전송할 수 있다.
Array Size 조정을 통한 Fetch Call 최소화
대량 데이터를 파일로 내려받는다면 데이터를 모두 전송해야하므로 가급적 Array Size를 크게 설정해야한다. Array Size를 조정한다고 해서 전송해야 할 총량이 변하진 않지만, Fetch Call 횟수를 그만큼 줄일수 있으며, 반대로 앞쪽 일부 데이터만 Fetch하다가 멈추는 프로그램이라고 할 경우 Array Size를 작게 설정하는 것이 유리하다.(불필요하게 많은 데이터를 전송하고 버리는 비효율을 줄일수 있음.)
쿼리 툴에서 부분범위 처리
모든 DBMS는 데이터를 조금씩 나눠서 전송한다. 즉, 부분범위 처리 방식으로 결과집합을 전송한다. 이 특징을 이용해 중간에 멈췄다가 사용자의 추가 요청이 있을 때마다 데이터를 가져오도록 구현하고 안하고의 차이는 책의 저자가 말하길 DBMS 클라이언트 프로그램을 개발하는 개발자의 몫이라고 말한다.
부분범위 처리 구현
개발 프레임워크에 미리 부분범위 처리 된 구현 기능을 활용하면 된다고 한다.
OLTP(Online Transaction Processing)
온라인 트랜잭션을 처리하는 프로그램을 말하며, 일반적으로 소량 데이터를 읽고 갱신한다. (하지만 항상 소량 데이터만 조회하는것은 아님)
수천수만 건을 조회하는 경우에는 많은 테이블 랜덤 액세스가 발생하기 때문에 제 성능을 내기 어려울수 있다. 버퍼캐시히트율이 좋다면 빠른 성능을 보일수 있지만, 아닌 경우도 존재하기 때문이다.
그러나 OLTP성 업무에서 쿼리 집합이 아주 많을 때 사용자가 모든 데이터를 일일이 다 확인하지 않는다. 특정한 정렬 순서로 상위 일부 데이터만 확인한다. (ex. 은행계좌 입출금 조회, 뉴스 또는 게시판 등등..) 주로 목록을 조회하는 경우. 이런 경우 항상 정렬 상태를 유지하는 인덱스를 이용하면, 정렬 작업을 생략하고 앞쪽 일부 데이터를 아주 바르게 보여줄수 있다. (인덱스와 부분범위 처리를 잘 활용한다면 OLTP환경에서 극적인 성능 개선 효과를 얻을수 있다고 함.)
멈출 수 있어야 의미있는 부분범위 처리(문제는 앞쪽 일부만 출력하고 멈출 수 있는가..? _부분범위 처리 핵심*)
해당 내용은 추후 5장 3절에서 다룬다고 함..
배치I/O : 읽는 블록마다 건건이 I/O Call을 발생시키는 비효율을 줄이기 위해 고안한 기능.
인덱스를 이용해 테이블을 액세스하다가 버퍼 캐시에서 블록을 찾지 못하면 일반적으로 디스크 블록을 바로 읽는데(오라클11g 까지), 배치I/O기능이 작동하면 테이블 블록에 대한 디스크 I/O Call을 미뤘다가 읽을 블록이 일정량 쌓이면 한꺼번에 처리한다. (오라클12c 이후 해당)
(* 12c에 도입된 일반 배치 I/O와 NL조인에 작동하는 기존 배치I/O는 파라미터, 힌트, 실행계획 표현방식이 모두 다르다.)
배치I/O를 통해 얻을수 있는 성능 이점이 많은에도 불구하고 시스템레벨에서 이를 비활성화 하는 경우가 종종있다. 이 기능을 비활성화하는 이유는 '필요한' order by를 생략한 SQL패턴 때문라고 한다. SQL에 order by가 없으면 결과 집합의 정렬 순서를 보장할 필요가 없으므로
옵티마이저가 배치I/O를 선택할 수 있고, 출력된 결과집합의 정렬 순서가 매번 다를수 있다.
데이터 정렬 이슈 :
배치I/O 기능이 작동하면 인덱스를 이용해서 출력하는 데이터 정렬 순서가 매번 다를수 있다는 사실에 주목해야 함..
Body가 존재하지 않는 HTTP Get 메소드에 @RequestBody를 활용하려고 한다면 에러가 발생한다. @RequestBody로 받는 데이터는 Spring에서 관리하는 MessageConverter 중 MappingJackson2HttpMessageConverter를 통해 JAVA객체로 변환하는데, 이는 ObjectMapper 라는 클래스를 이용한다.
@RequestParam : 1개의 HTTP요청 파라미터를 받기 위해서 사용한다. @RequestParam은 필수 여부가 true이므로 반드시 해당 파라미터가 전송되어야 하며, 파라미터가 전송되지 않으면 400에러를 발생한다. (필수값이 아닌경우 required를 false로 설정하는 방법이 있으며, defaultValue옵션을 사용하면 기본값 역시 지정 가능하다.)
@ModelAttribute : 클라이언트가 전송하는 multipart/form-data 형태의 HTTP Body와 HTTP 파라미터의 값들을 생성자나 Setter를 통해 주입하기 위해 사용된다. @ModelAttribute에는 매핑시키는 파라미터의 타입이 객체의 타입과 일치하는지를 포함한 다양한 검증(Validiation) 작업이 추가적으로 진행되는데, 예를 들어 게시물의 번호를 저장하는 int형 index 변수에 "1번" 이라는 String형을 넣으려고 한다면, BindException이 발생하게 된다. @ModelAttribute을 사용해서 특정 Parameter 값 만을 가져올 수도 있다.
* ObjectMapper의 동작과정 : ObjectMapper는 Json 메세지를 자바 객체로 변환하는 과정에서 객체의 기본 생성자를 통해 객체를 생성하고, 내부적으로 Reflection을 사용한다. 그래서 반드시 @Setter가 필요한 것은 아닌데, @Getter나 @Setter 혹은 @JsonInclude 등 필드에 있는 변수들의 이름을 찾기 위한 메소드들을 필요로 한다.
그러므로 기본생성자 + @Getter로 클래스를 구현해주면 @Setter가 없어도 값이 바인딩된다.